
AlphaGo'nun Hikâyesi: Yapay Zekâ En Zor Masa Oyununu Nasıl Fethetti
Sanki her oyunu aynı son bekliyor: bilgisayarlar güçlendikçe bizi geçiyor. Damada Chinook, 1994’te hastalığı yüzünden rövanştan çekilmek zorunda kalan Marion Tinsley’in unvanını devraldı; satrançta Deep Blue, Garry Kasparov’u devirdi (1997).
Go bu kaderin dışında kalacak gibiydi: dallanma faktörü öyle büyüktü ki kaba kuvvet araması çöküyordu; programlar yıllarca güçlü insan oyuncuların çok gerisinde kaldı.
Deep Blue’dan yirmi yıl bile geçmeden, 2015’te DeepMind AlphaGo’yu tanıttı. Bir yıl içinde bütün o varsayımlar altüst oldu; Go’da “sezgi” ile “yaratıcılık” ne demek, baştan düşünmek gerekti.
İnsan üstünlüğünün son kalesi Go, işte o eşikte yapay zekânın sınav alanına dönüştü.
Bu yazı, Go Magic kanalımızdaki videodan uyarlandı.
Go Neden Farklı?
Yapay zekâ sahneye çıkmadan önce oyunun kendisine kısaca bakalım. Go’nun kuralları bir dakikada anlatılacak kadar basit; ortaya çıkan konumlarsa sürprize ve belirsizliğe açılıyor. Bilgisayarları uzun yıllar güçlü insan oyuncuların gerisinde tutan da bu ikili.
Basit kurallar, sınırsız karmaşıklık
Oyuncular siyah ve beyaz taşları boş kesişim noktalarına koyar; önce Siyah oynar, Beyaz yanıt verir, sıra böyle dönüp durur. Amaç, tahtayı güvenli alanlara bölmek; taş almak hedefin kendisi değil, ona giden yollardan biri. Bir taşın nefesleri, ona komşu boş kesişim noktalarıdır; hepsi doldurulduğunda taş tahtadan kalkar. En basit örnekte tek bir beyaz taşın dört komşu noktası olur; Siyah dördünü de kapattığında taş ele geçirilir. Bu küçücük kural kümesinden doğan karar ağacı, düz hesabın sınırlarını hızla aşar. Kuralların adım adım, daha ayrıntılı anlatımı için etkileşimli rehberimize göz atın.

Eski Go programları insanların çok gerisindeydi; birkaç aylık çalışma bile bir insanı dönemin en güçlü motorlarının önüne geçirmeye yetiyordu. Bunun yapısal bir nedeni vardı: Go, kaba kuvvet aramasının çözebileceğinden çok daha fazla varyant üretir. Pratikte oyun hem yerel okumaya hem sezgiye dayanır. Konumlar o kadar öngörülemez ki oyuncular çoğu zaman her şeyi tam olarak hesaplayamaz; hamlelerini sezgiyle seçer. Makineler aradaki farkı ancak yeni algoritmalarla kapatmaya başladı.
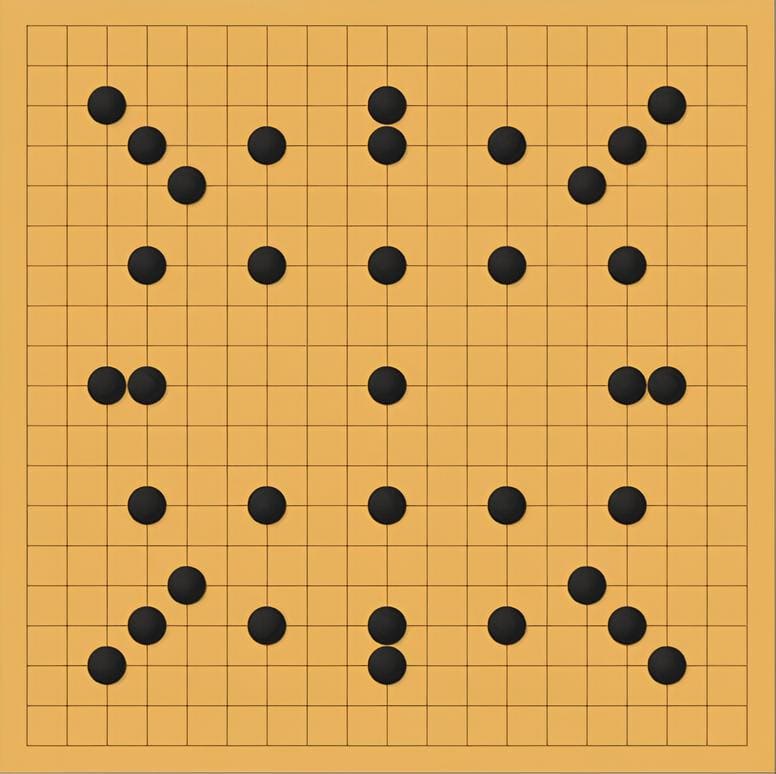
Avanslı oyunda zayıf taraf, daha ilk hamleden önce tahtaya taş koyar — iki, üç, beş, hatta daha fazla — böylece seviye farkı olan maçlar da anlamını korur. Aynı düzenler erken dönem programları için dayanıklılık testine dönüştü. Tahta baştan aşağı siyah taşlarla doldurulsa bile, ezici görünen o konumlarda insanlar programları epey rahat yeniyordu.
Kırılma Anı
Yıllarca eğri yavaş yükseldi: yeni algoritmalar, daha iyi programlar, istikrarlı ama gösterişsiz bir ilerleme. Sonra 2015 geldi, hikâye keskin bir viraja girdi.
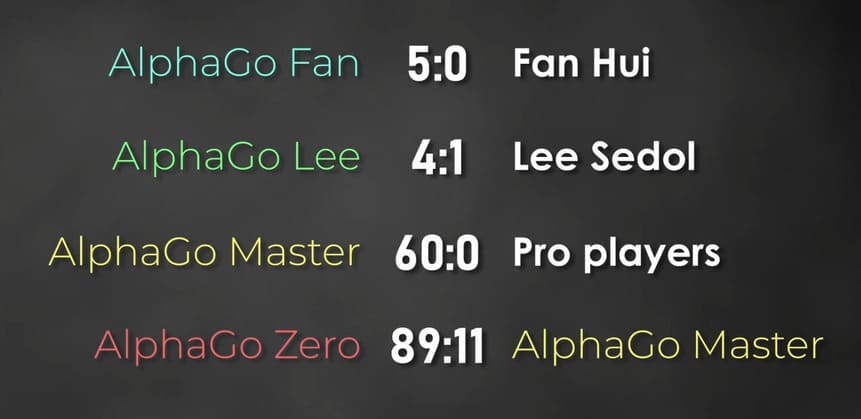
DeepMind ekibi Fan Hui’ye ulaştı: Çin doğumlu, o sırada Fransa’da yaşayan 2 dan bir profesyonel ve en önemlisi üç kez Avrupa şampiyonu. Doğal bir ilk sınavdı. Ekim 2015’te iki taraf beş oyunluk bir maç oynadı. Fan Hui de dönemin çoğu profesyoneli gibi kuşkuluydu; deneyim, hiçbir programın güçlü bir insanı gerçekten yenemeyeceğini söylüyordu. Bu beklenti neredeyse anında çöktü. İlk oyundan sonra dengenin değiştiği açıktı; maç beş oyunda beş yenilgiyle, tam bir hezimetle bitti. Sonuç pek çok gözlemciyi sarstı ama Go dünyası kendini kesin olarak yenilmiş saymadı; birçok oyuncu bunun hâlâ “gerçek” insan-makine hesaplaşması olmadığını düşünüyordu.
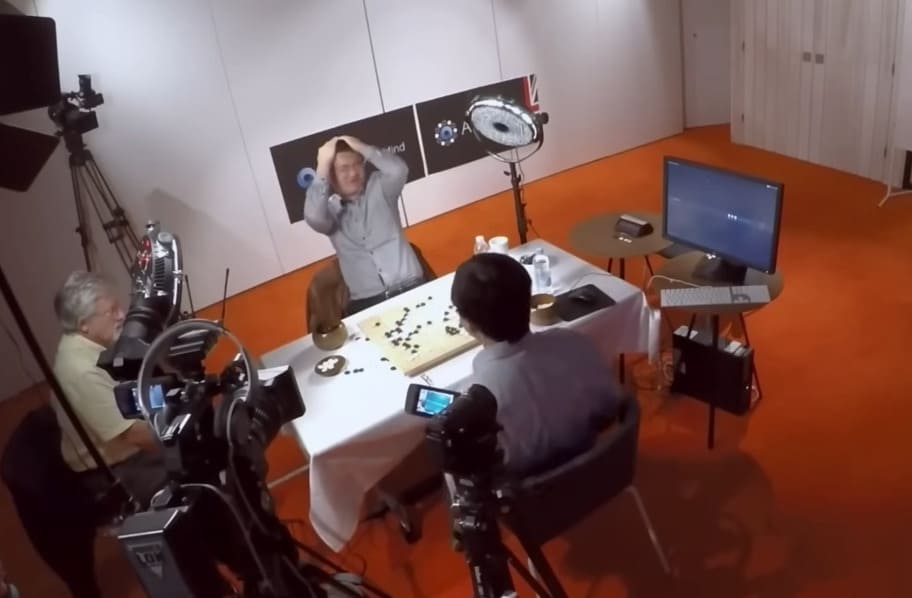
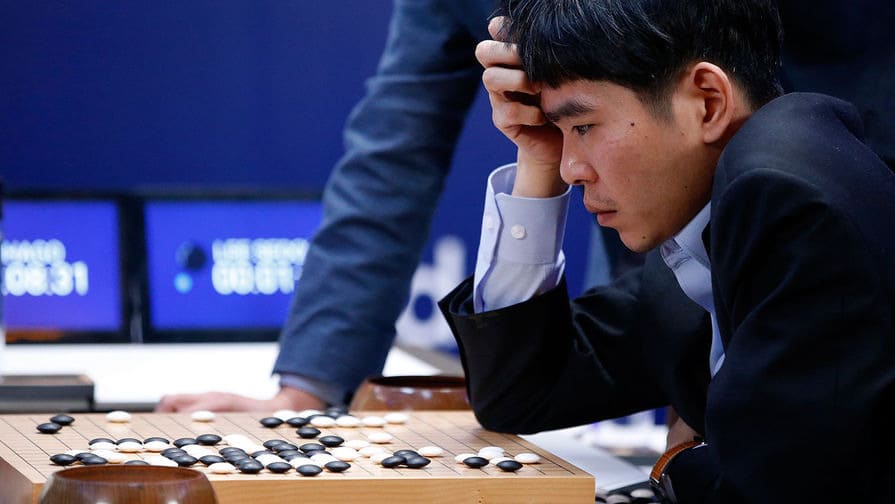
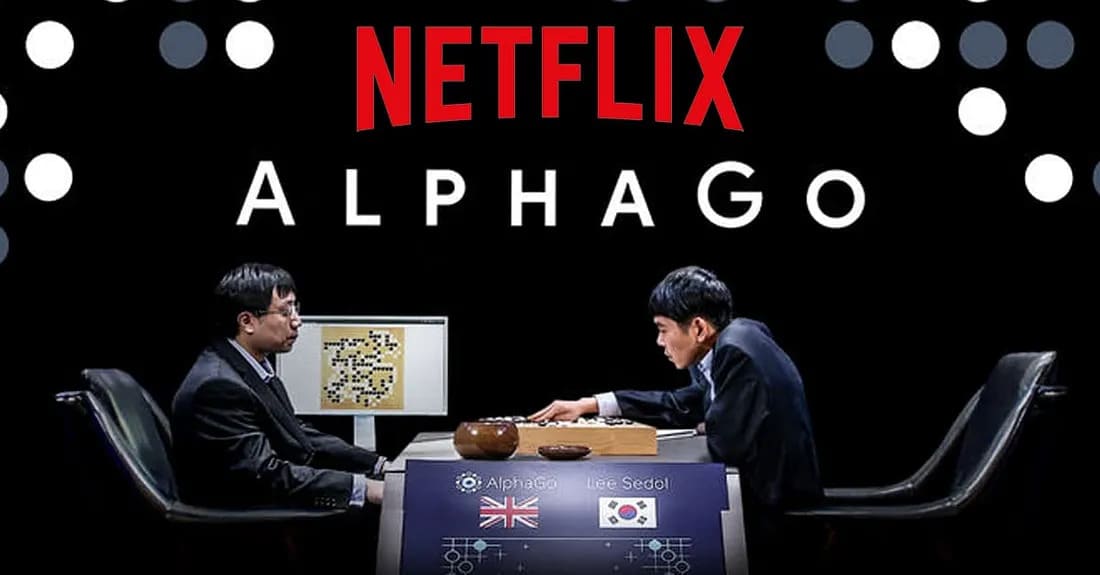
Daha büyük bir sınav kaçınılmazdı. Ertesi yılın rakibi bir efsane olacaktı: Güney Koreli Lee Sedol. 2015’in diliyle akılda kalan benzetme şuydu: “Go’nun Michael Jordan’ı”. On sekiz uluslararası unvan, agresif ve sezgisel üslubuyla ün yapmış bir oyuncu. Maçtan önce Lee, Fan Hui’nin beş oyununu inceledi; tıpkı ondan önce Fan Hui gibi o da ikna olmadı. Ekrandaki seviye kendi seviyesinin altındaydı; rahat kazanmayı bekliyordu. Öngöremediği şey, AlphaGo’nun buluşmadan önce gördüğü ek eğitimdi; Mart 2016 sahnesini asıl o hazırlık belirledi.
Lee Sedol’a Karşı AlphaGo
2016’nın ilk aylarında beklenti giderek büyüdü; soru artık sportif olduğu kadar kültüreldi: yaşayan bir efsane, karşılaşmalar arasında biraz daha güçlenen bir makineyle buluşursa ne olur? Bahisler insandan yanaydı, çoğu Lee Sedol’a oynanmıştı. Etkinlik oyun salonunun dışına taştı: birden fazla dilde canlı anlatım, Seul’ün sokaklarını izleme salonuna çeviren dev açık hava ekranları. İlk taş tahtaya konduğunda ortada insan sezgisi için küresel bir dayanıklılık sınavı vardı.
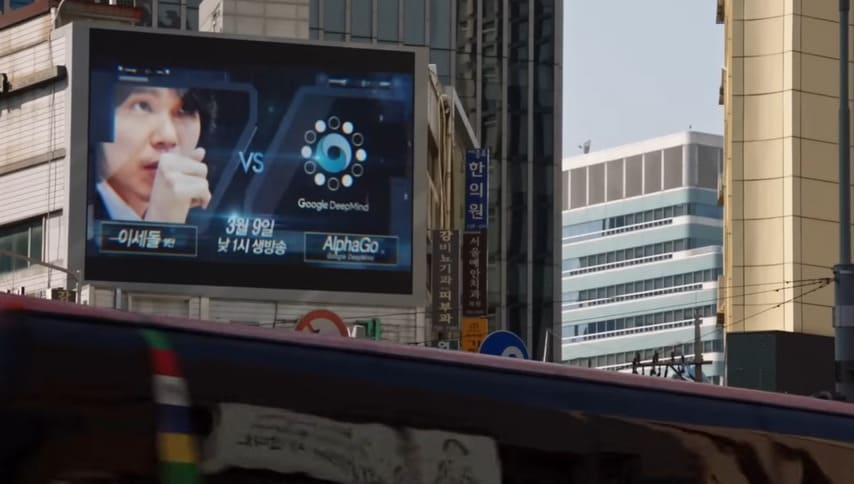
1. oyun: erken savaş ve beklenmedik bir makine üslubu
Yaygın kanı şuydu: bir program, üst düzey bir profesyonele karşı erken karmaşadan kaçınmalı. AlphaGo tam tersini yaptı: daha açılışta sert bir savaş başlatarak insanın avantajlı sayıldığı senaryoyu seçti ve şaşırtıcı bir rahatlıkla kazandı. Lee afallamıştı; asıl mücadele daha yeni başlıyordu.
2. oyun: “imkânsız” 37. hamle
İkinci oyun, salonun nefesini kesen bir an yarattı. 37. hamlede makine, insanların “oynamadığı” bir yolu seçti. Temel diye ezberletilen oyun ilkelerini doğrudan çiğniyordu; ama tahtadaydı, sakin ve kendinden emin. Salondakiler donakaldı; hamle “izleyen herkesi şaşırttı”. İnsan öğretisine göre böyle bir seçim “oynanamaz” sayılırdı. Sistem yine de bu hamleyi oynadı, üstelik işe yaradı. O anda maç, veri tabanı taklidi üzerine bir referandum olmaktan çıktı; programın kendi veri kümelerini aşabildiğini, öğrendiği insan oyunlarının ötesine geçip yaratıcı bir şey bulabildiğini gösterdi. Günün geri kalanı şoku doğruladı. AlphaGo oyunu kazanıp 2–0 öne geçti; artık Lee Sedol’u maçta ancak olağanüstü fikirler tutabilirdi.
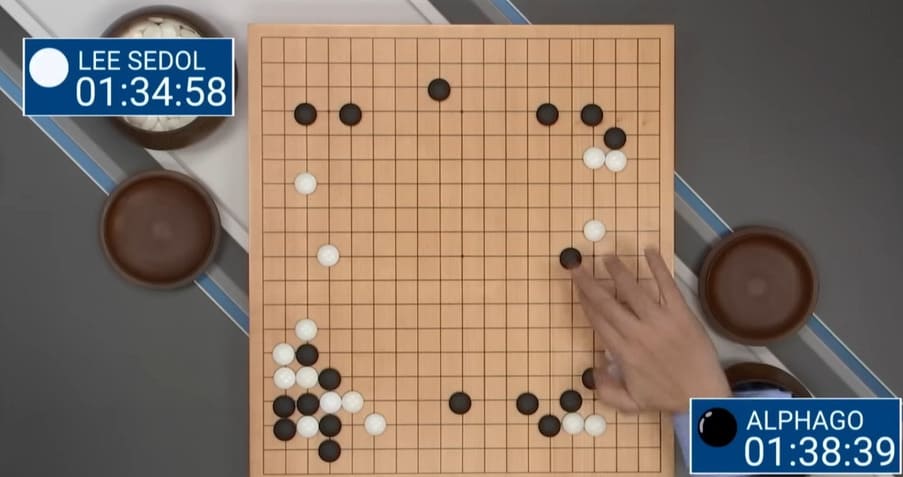
3. oyun: gidişatı tersine çevirme denemesi
Maç elinden kayarken Lee’ye tek yol kalmıştı: işleri karmaşıklaştırmak, daha açılışın başında büyük bir savaş çıkarmak. Tutmadı. AlphaGo konumunu sağlamlaştırdı, yine kazandı; skor 3–0 olduğunda maç fiilen bitmişti.
4. oyun: insanın başyapıtı, 78. hamle
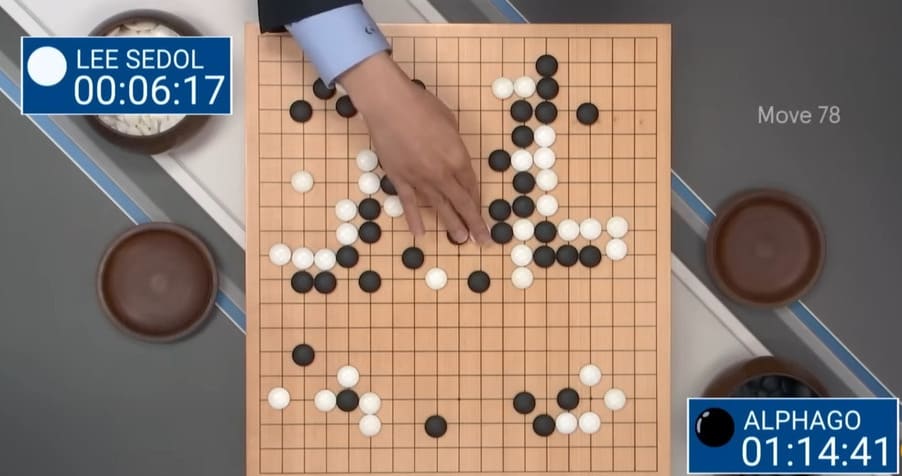
Dördüncü oyunun ortasında maç bitmiş gibiydi. AlphaGo yaklaşık on puan öndeydi; bu seviyede böyle bir fark, genelde sona doğru sakin bir gidişin habercisi olur. Sonra, mucizelere kapalı görünen bir konumda Lee Sedol, salondaki hiç kimsenin göremediği tek bir çarpıcı fikir buldu. Hamle, sistemin kör noktasına denk geldi. AlphaGo’nun değerlendirmesi sendeledi, konumu çözemedi, inisiyatif el değiştirdi. Go anlatılarında o kıvılcımın bir adı var: 78. hamle. Sonraki incelemeler — 2016 sürümünden çok daha güçlü yapay zekâlarla — taktiğin ilke olarak işlememesi gerektiğini söyledi; ama o sürüme karşı, o gün işledi. Lee üstünlüğü sonuca çevirip kazandı. Sahnenin önemi skor tablosunun ötesindeydi: maçın ruhuna dair bir şey kanıtladı. İlk üç oyun, sessizce güçlü ve buluşlarıyla şaşırtan bir makine göstermişti; dördüncüsü, insan yaratıcılığının o zırhta hâlâ çatlak açabildiğini ortaya koydu. Bu, o makineye karşı kazanılmış tek insan galibiyeti olarak kaldı — efsaneye dönüşen bir istisna.
5. oyun: maçı kapatmak
Beşinci oyun, rüzgâr henüz yön değiştirmişken, iki tarafın da sinirleri gerginken başladı. Lee yine bastırdı; işleri karmaşıklaştıracak, tahtayı yeniden açacak yollar aradı. AlphaGo baskıyı sakin karşıladı, orta oyunda verimli değiş tokuşlar yaptı, küçük üstünlüğü sağlam bir farka çevirdi. Alan sayımı netleşince Lee oyunu terk etti. Seyirci hem bir gün önceki insan başyapıtını hem de sistemin toparlanıp hemen ertesi oyunu kazanabildiğini gördü.
Son skor, kalıcı anlam
Maç 4–1 bitti. Skorun ötesinde yeni bir örüntü vardı: insan alışkanlıklarının dışına çıkan, en parlak ışıkların altında bile üretmeyi sürdüren bir yapay zekâ. O hafta insanlar Go’da makinelere kesin olarak yenildi; aynı hafta yapay zekânın yaratıcı arayışı bir varsayım olmaktan çıkıp tahtada görünür oldu.
Maçın bıraktığı mirası, bugün oyunculara ne ifade ettiğini daha yakından ele aldığımız yazımıza göz atın: “Lee Sedol, AlphaGo’ya Karşı: Maçta Gerçekte Ne Oldu?”.
AlphaGo’dan AlphaGo Zero’ya
Seul’den sonra daha güçlü sürümler gelmeye devam etti; ama yoldaki asıl dönüş bir yıl sonraydı: çok farklı bir sistem, yeni bir ad ve yeni bir iddiayla sahneye çıktı.
Yeni sistemin adı AlphaGo Zero’ydu; “Zero”, yani sıfır, çünkü Go’yu en baştan öğrendi. İnsan oyunlarından oluşan bir arşiv yoktu, devralınmış joseki ya da profesyonel alışkanlıkları yoktu; yalnızca temel kurallar ve ardından hiç durmayan bir kendi kendine oynama.
Başlangıçta oyunlar insan ölçütlerine göre berbattı: binlerce tökezleme, neredeyse rastgele görünen hamleler. Ama öğrenme döngüsünün zarafetle işi yoktu; sonuçla işi vardı. Milyonlarca, on milyonlarca kendi kendine oyunun ardından sistemin gücü istikrarlı biçimde tırmandı.
Sonuç açıktı: sıfırdan öğrenen sistem, insan verisiyle eğitilmiş bütün önceki sürümleri geçti. Yani insan başlangıç noktasını kaldırmak — “insan faktörünü” denklemden çıkarmak — makine için daha iyi oldu.
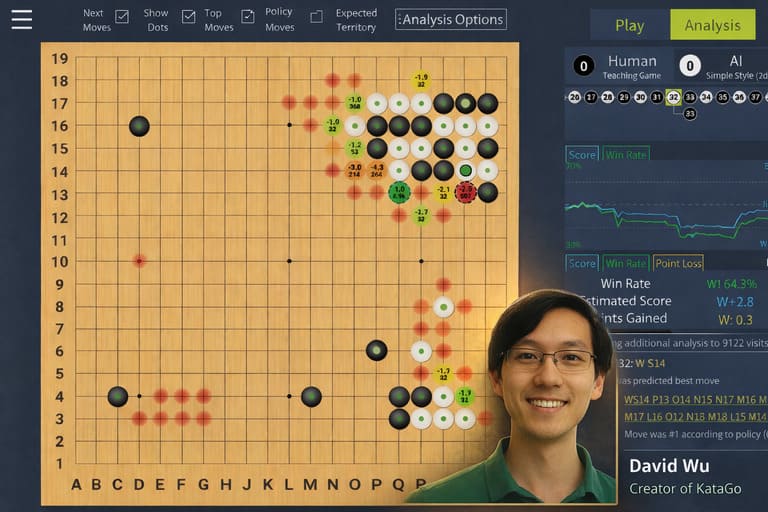
Bunun önemi yalnızca hız ya da güçte değil, yöndeydi. İnsan örneklerinden kopmuş bir sistem, kimsenin öğretmediği varyantları keşfedebiliyor, yıllardır süren tartışmalara kararlı seçimlerle yanıt verebiliyor, bir zamanlar aykırı görünen fikirleri sıradanlaştırabiliyordu. Yıllar sonra insanüstü Go yapay zekâsı herkesin araç çantasında; oyuncuların çalışma biçimi ve oyunun evrimi için hem nimet hem külfet.
Modern Go analiz motorlarını kendi bilgisayarınıza kurmak için adım adım rehberimize bakın: “Yapay Zekâyla Go Analizi İçin Yazılım Kurulumu”
İnsan Go’sunun Ötesinde: Son Değil, Başlangıç
Hikâye karamsar bir yerde bitmiyor. Dokuz yıl önceki o zafer, bir makineye Go, XOX ya da StarCraft oynamayı öğretmekten fazlasıydı. Bir yöntemi görünür kıldı: AlphaGo, karmaşık görevler için yapay zekânın nasıl doğru eğitileceğini gösterdi.
2025’e gelindiğinde bu yöntem 19×19’luk tahtanın çok ötesine geçti: insan konuşmasını anlayan, görüntü ve video üreten, müzik besteleyen, çok daha fazlasını yapan sistemler artık gündelik hayatın parçası. Yine de araştırmanın sınırı açık: iş tamamlanmadı, türümüz için ne anlama geleceği de hâlâ belirsiz.
Go’nun çevresindeki tartışma da genişliyor. Artık mesele yalnızca “bu oyun nasıl oynanır” değil; tahtanın etrafında dönen fikirler, teknoloji, yaratıcılık, oyuncularla hayranlar için doğan sonuçlar da işin içinde. Son satır bir nokta değil, üç nokta: tek bir tahtadan geniş dünyaya, sıradaki hamle hâlâ yazılmadı.




Yorumlar