
A história do AlphaGo: como a IA conquistou o jogo de tabuleiro mais difícil
Todo jogo parece ter o mesmo destino: conforme os computadores evoluem, nos ultrapassam — do Chinook, que herdou o título de Marion Tinsley nas damas em 1994, quando a doença o obrigou a abandonar a revanche, ao Deep Blue sobre Garry Kasparov no xadrez (1997).
O Go parecia imune: o fator de ramificação era tão grande que a força bruta não dava conta, e por anos os programas de Go ficaram muito atrás dos jogadores humanos fortes.
Menos de vinte anos depois do Deep Blue, em 2015, a DeepMind apresentou o AlphaGo — e em menos de um ano ele já tinha derrubado essas certezas, obrigando o mundo do Go a repensar o que são “intuição” e “criatividade”.
Foi ali que a última fronteira do Go virou o campo de provas da IA.
Este artigo é uma adaptação de um vídeo do nosso canal Go Magic.
Por que o Go é diferente
Antes de a IA entrar na história, vale entender o jogo em si. No Go, as regras são simples o bastante para explicar em um minuto, e as posições logo se abrem para a surpresa e a incerteza. Foi essa combinação que manteve os computadores muito atrás dos jogadores humanos fortes por tanto tempo.
Regras simples, complexidade sem limites
Os jogadores colocam pedras pretas e brancas nas intersecções vazias: as Pretas começam, as Brancas respondem e daí em diante os dois se alternam. O objetivo é dividir o tabuleiro em áreas de território seguro, e a captura é um meio, não o fim. As liberdades de uma pedra são as intersecções vazias vizinhas; preencha todas e a pedra sai do tabuleiro. No exemplo mais básico, uma pedra branca sozinha tem quatro intersecções vizinhas — quando as Pretas ocupam as quatro, a pedra é capturada. A partir desse punhado de regras, a árvore de decisões do jogo logo ultrapassa qualquer cálculo direto. Para um passo a passo mais aprofundado das regras, veja o nosso guia interativo.

Os primeiros programas de Go ficavam muito atrás dos humanos: bastavam alguns meses de estudo para uma pessoa passar à frente dos melhores da época. A razão estrutural era clara: o Go tem variações demais para a busca por força bruta dar conta. Na prática, jogar é misturar leitura local e sensibilidade. As posições são imprevisíveis o bastante para que muitas vezes não dê para calcular tudo com precisão — e aí a jogada escolhida nasce da intuição. Só com algoritmos novos as máquinas começaram a encurtar essa distância.
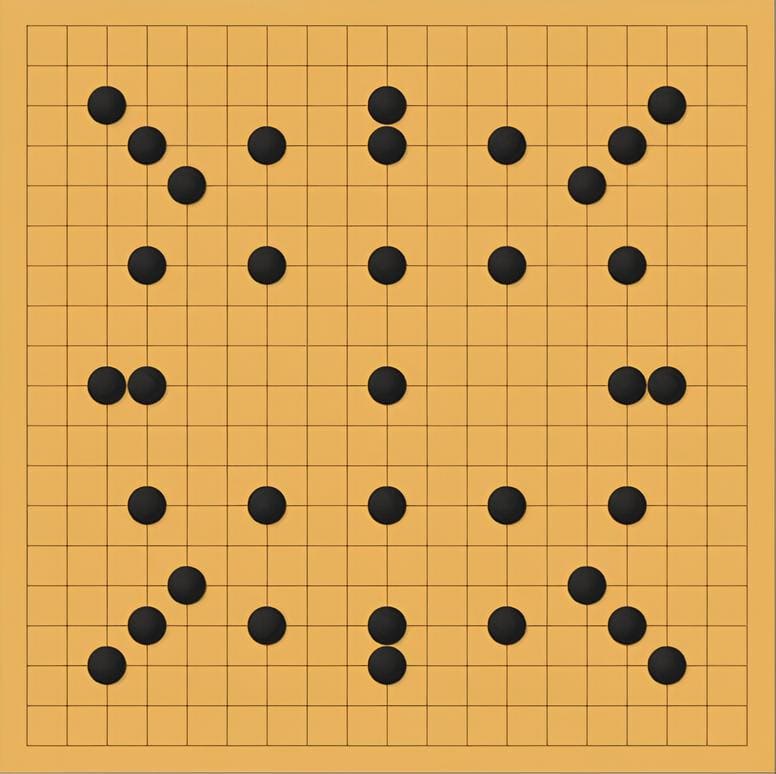
No jogo com handicap, o lado mais fraco coloca pedras antes da primeira jogada — duas, três, cinco ou mais — para que a partida continue interessante mesmo com uma diferença grande de nível. Esses mesmos arranjos viraram um teste de estresse para os primeiros programas. Mesmo em posições que pareciam esmagadoramente favoráveis, com o tabuleiro inteiro coberto de pedras pretas, os humanos ainda venciam os programas sem muito esforço.
A virada
Por anos a curva foi suave: algoritmos novos, programas melhores, um avanço constante e sem espetáculo. Aí veio 2015 e a história deu uma guinada.
A equipe da DeepMind procurou Fan Hui, profissional de 2 dan, nascido na China, na época radicado na França e, o mais importante, tricampeão europeu. Era o primeiro teste natural. Em outubro de 2015 os dois lados disputaram uma série de cinco partidas. Como quase todos os profissionais da época, Fan Hui estava cético: a experiência dizia que nenhum programa era capaz de vencer um humano forte de verdade. A expectativa desabou quase de imediato. Depois da primeira partida já estava claro que o equilíbrio havia mudado, e a série terminou numa varrida: cinco derrotas em cinco partidas. O resultado chocou muita gente, mas o mundo do Go não se sentiu derrotado de vez — muitos jogadores desconfiavam de que aquele ainda não era o “verdadeiro” acerto de contas entre humano e máquina.
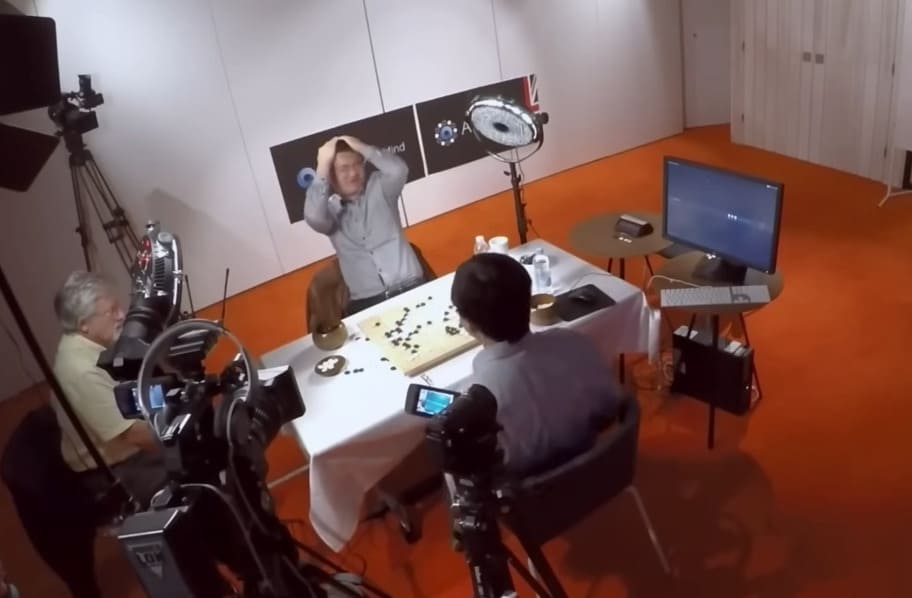
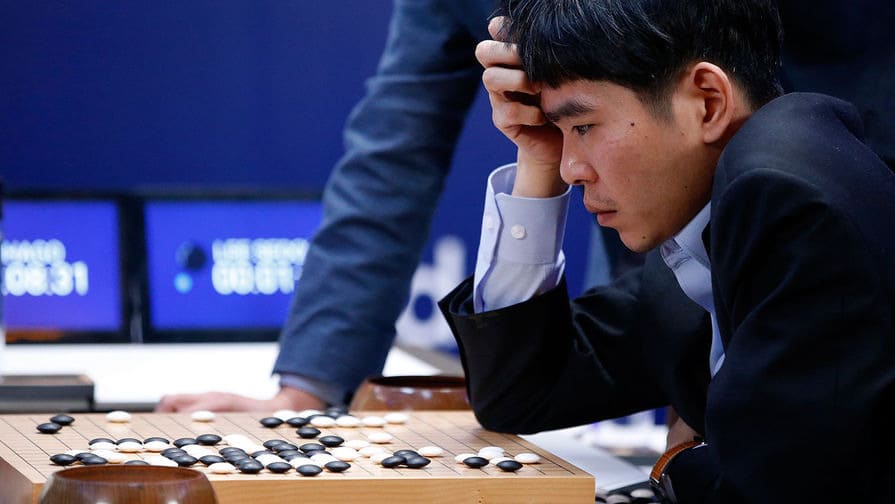
Um teste maior era inevitável. O adversário do ano seguinte seria uma lenda: o sul-coreano Lee Sedol. Pelos padrões de 2015, a comparação que pegou foi “o Michael Jordan do Go”: dezoito títulos internacionais e um estilo agressivo e intuitivo. Antes do confronto, Lee revisou as cinco partidas contra Fan Hui e, como Fan Hui antes dele, não se convenceu — o nível ali parecia abaixo do dele, então esperava vencer com folga. O que não viu chegar foi o treino extra do AlphaGo até o encontro, uma preparação que mudaria o cenário de março de 2016.
Lee Sedol vs. AlphaGo
A expectativa cresceu ao longo do começo de 2016 até a pergunta virar tão cultural quanto esportiva: o que acontece quando uma lenda viva encontra uma máquina que fica mais forte a cada aparição? O favoritismo estava com o lado humano, e a maioria apostava em Lee Sedol. O evento transbordou da sala de jogo: transmissão comentada em vários idiomas e telões nas ruas de Seul, que viraram salas de projeção a céu aberto. Quando a primeira pedra tocou o tabuleiro, aquilo parecia um teste de estresse global da intuição humana.
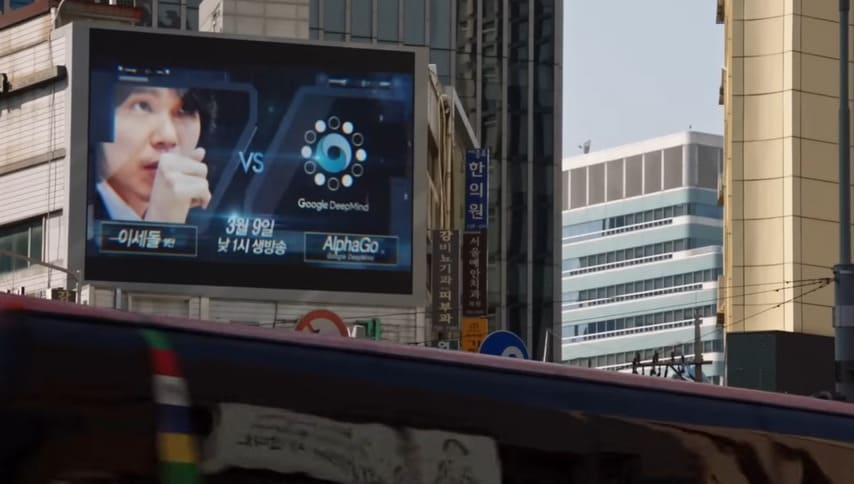
Partida 1: briga logo na abertura e um estilo de máquina inesperado
O senso comum dizia que um programa deveria fugir do caos logo cedo contra um profissional de elite. O AlphaGo fez o contrário: começou uma luta acirrada já na abertura, exatamente o cenário que se imaginava favorável ao humano — e venceu com uma facilidade desconcertante. Lee ficou perplexo, e a batalha de verdade, ao que parecia, mal tinha começado.
Partida 2: a jogada 37 “impossível”
A segunda partida teve um momento que congelou a sala. Na jogada 37, a máquina escolheu uma linha que os humanos “não jogam”. Aquilo atropelava os princípios mais básicos do jogo, o tipo de coisa que se treina como fundamento — e mesmo assim estava ali no tabuleiro, calma e sem pedir licença. Os espectadores ficaram atônitos: a jogada “surpreendeu todo mundo que assistia”. Pela doutrina humana, aquela escolha “não se joga”. E, ainda assim, o sistema jogou e fez aquilo funcionar. Naquele instante, o confronto deixou de ser um teste sobre se a máquina apenas imitava um banco de dados. Virou a demonstração de que o programa podia ir além dos conjuntos de dados originais, passar por cima das partidas humanas com que aprendeu e achar algo criativo. O resto do dia confirmou o choque: o AlphaGo venceu e abriu 2 a 0, empurrando Lee Sedol para o terreno em que só ideias extraordinárias manteriam a série viva.
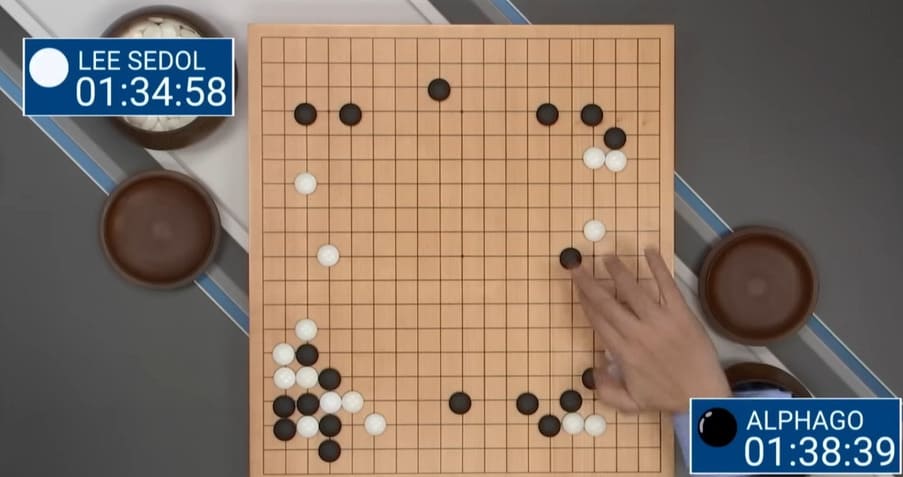
Partida 3: a tentativa de virar o jogo
Com a série escapando, Lee foi pelo único caminho que restava: forçar complicações e partir para uma luta enorme já na abertura. Não colou. O AlphaGo estabilizou e venceu de novo. Com 3 a 0, o confronto estava decidido na prática.
Partida 4: a obra-prima humana, a jogada 78
Na metade da quarta partida, tudo parecia resolvido. O AlphaGo liderava por uns dez pontos, uma margem que, nesse nível, costuma significar um passeio tranquilo até o fim. Então, numa posição que parecia fechada para milagres, Lee Sedol encontrou uma ideia única e impressionante que ninguém no local enxergou. A jogada acertou o ponto cego do sistema. A avaliação do AlphaGo vacilou, o programa não conseguiu resolver a posição e a maré virou. Essa faísca tem nome na história do Go: a jogada 78. Estudos posteriores, com IA muito mais forte do que a de 2016, indicaram que a tática não deveria funcionar em princípio — mas contra aquele programa, naquele dia, funcionou. Lee converteu a vantagem e venceu. Além do placar, a cena importou porque provou algo sobre o espírito do confronto. As três primeiras partidas mostraram uma máquina capaz de força silenciosa e de invenções assustadoras; a quarta mostrou que a criatividade humana ainda conseguia abrir uma fresta na armadura. Continua sendo a única vitória humana contra aquela máquina, uma exceção que virou lenda.
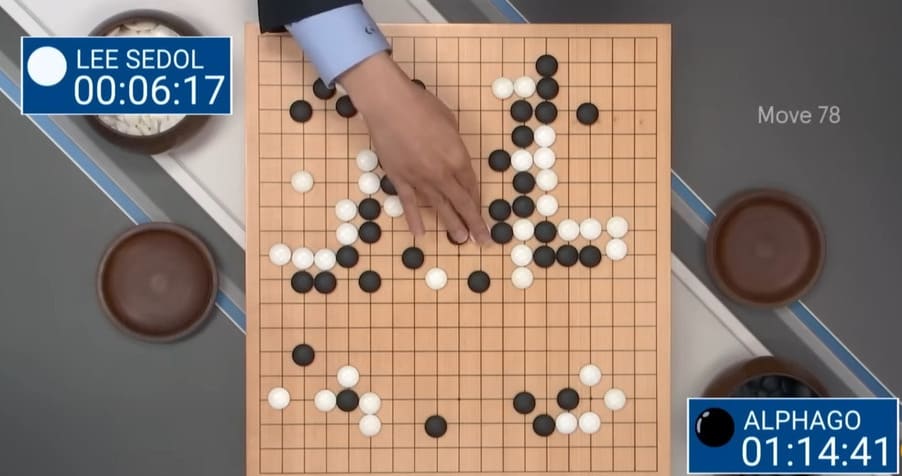
Partida 5: o desfecho da série
A quinta partida chegou com a maré recém-virada e, dos dois lados, os nervos à flor da pele. Lee pressionou de novo, atrás de complicações e de um jeito de reabrir o tabuleiro. O AlphaGo respondeu à pressão com calma, fez trocas eficientes no meio-jogo e transformou uma pequena vantagem numa liderança estável. Quando a contagem de território ficou clara, Lee desistiu. A plateia viu as duas coisas: a obra-prima humana da véspera e a capacidade do sistema de dar a volta por cima e vencer já na partida seguinte.
Placar final, sentido duradouro
O confronto terminou em 4 a 1. Além do placar, ficou um padrão novo: uma IA capaz de sair dos hábitos humanos e ainda entregar sob os holofotes mais fortes. Foi a semana em que os humanos finalmente perderam para as máquinas no Go — e a semana em que a busca criativa feita por uma IA deixou de ser especulação e apareceu no tabuleiro.
Para um olhar mais fundo sobre o legado do confronto e o que ele significa para os jogadores de hoje, veja o nosso artigo “Lee Sedol e AlphaGo: o legado de uma luta histórica!”:
Do AlphaGo ao AlphaGo Zero
Depois de Seul, versões mais fortes continuaram chegando, mas a curva de verdade veio um ano depois, quando um sistema bem diferente subiu ao palco com um nome novo e uma premissa nova.
O sistema novo se chamava AlphaGo Zero — “Zero” porque aprendeu o Go do zero. Sem acervo de partidas humanas, sem joseki herdado nem manias de profissional: só as regras básicas e depois um jogo contra si mesmo sem trégua.
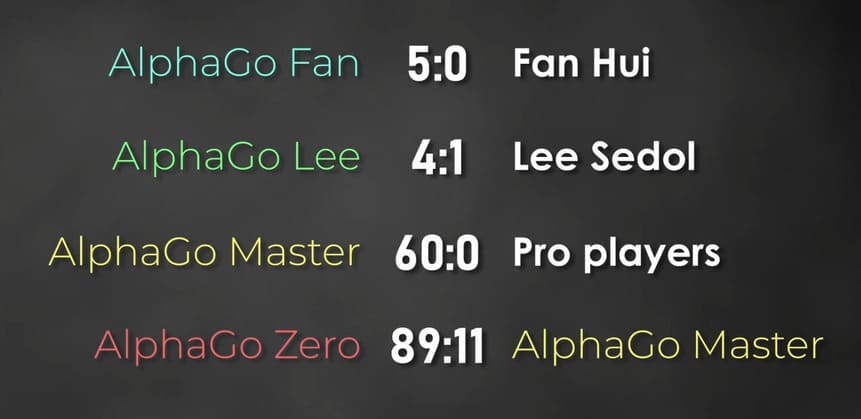
No começo, as partidas eram horríveis para os padrões humanos: milhares de tropeços, jogadas que pareciam quase aleatórias. Mas o ciclo de aprendizado não estava atrás de elegância, e sim de resultado. Com milhões e milhões de partidas contra si mesmo, a força do sistema subiu sem parar.
O resultado foi direto: quem aprendeu do zero superou todas as versões anteriores treinadas com dados humanos. Ou seja, tirar o ponto de partida humano — excluir o “fator humano” — acabou sendo melhor para a máquina.
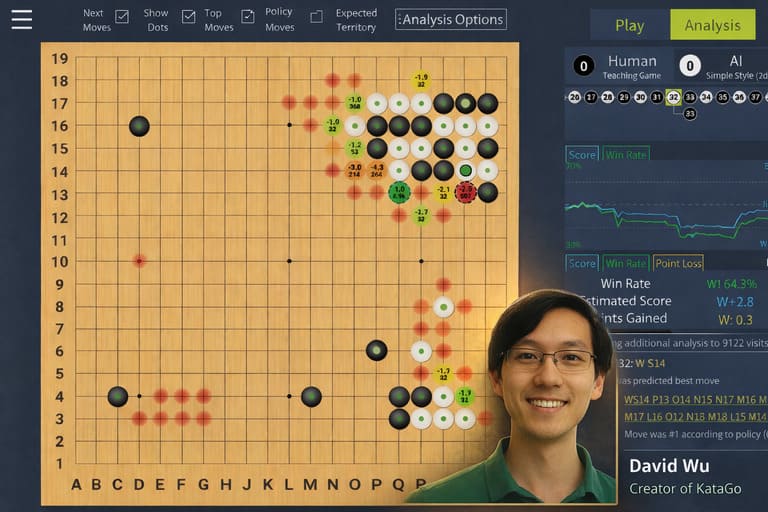
O que importava ali não era só velocidade ou força, mas direção. Um sistema livre dos exemplos humanos podia explorar linhas que ninguém tinha ensinado, responder a perguntas antigas com escolhas firmes e normalizar ideias que antes pareciam heterodoxas. Anos depois, a IA sobre-humana de Go está na caixa de ferramentas de todo mundo — bênção e maldição para a forma como os jogadores estudam e como o jogo evolui.
Para instalar programas modernos de análise de Go no seu computador, siga o nosso guia passo a passo “Como instalar programas para analisar partidas de Go com IA”
Além do Go humano: um começo, não um fim
A história não termina em tom sombrio. Aquela vitória de nove anos atrás significou mais do que ensinar uma máquina a jogar Go, jogo da velha ou StarCraft. Ela revelou um método: o AlphaGo mostrou como treinar IA do jeito certo para tarefas complexas.
Em 2025, esse método vai muito além de um tabuleiro 19×19: sistemas que entendem a fala humana, geram imagens e vídeo, compõem música e muito mais já fazem parte do dia a dia. Ainda assim, a fronteira da pesquisa segue aberta — um trabalho inacabado, de teto incerto, e ninguém sabe ao certo o que ele vai significar para a nossa espécie.
Em torno do próprio Go, a conversa se amplia. Estudar já não é só “como jogar este jogo”, mas também as ideias que orbitam o tabuleiro: a tecnologia, a criatividade, o que tudo isso significa para jogadores e fãs. A última linha não é um ponto final, e sim reticências — de um tabuleiro para o mundo inteiro, a próxima jogada ainda está por ser escrita.




Comentários